

Організації зберігають два принципово різних типи даних, і більшість програмного забезпечення з безпеки обробляє їх однаково. У цьому й полягає проблема.
Структуровані дані зберігаються в базах даних, відповідають фіксованим схемам і поводяться передбачувано. Неструктуровані дані зустрічаються всюди: у контрактах, електронних листах, журналах чатів, PDF-файлах, аудіофайлах, презентаціях. Вони не підкоряються жодним правилам, не дотримуються жодних схем і розростаються швидше, ніж більшість команд може відстежити. Кожен тип даних вимагає різного управління, різних заходів контролю та, у разі виникнення проблем, різного реагування на інциденти.
У цій статті пояснюються відмінності між структурованими та неструктурованими даними, чому ці відмінності створюють різні ризики для безпеки та як застосовувати належні заходи захисту в хмарних, локальних та ШІ-середовищах.
Що таке структуровані дані?
Структуровані дані — це інформація, організована за заздалегідь визначеною схемою. Вони розміщуються у рядках і стовпцях із фіксованими типами полів, визначеними зв’язками та передбачуваними шаблонами. Типові приклади включають:
- У CRM-системі містяться записи про клієнтів із полями для імені, електронної пошти та статусу облікового запису.
- Журнали транзакцій у фінансовій базі даних.
- Медичні записи зі стандартизованими ідентифікаторами.
- Таблиці обліку запасів і ланцюгів постачання в системі ERP.
- Дані про персонал зберігаються в узгоджених, перевірених полях.
Оскільки структуровані дані відповідають схемі, до них можна звертатися за допомогою SQL, їх можна перевіряти стандартними інструментами та відносно легко класифікувати. Ви знаєте, де знаходяться дані, що вони містять і хто має до них доступ. Ця передбачуваність — їхня сильна сторона, але вона також створює хибне відчуття контролю.
Ризик, пов’язаний зі структурованими даними, полягає не в тому, що їх важко знайти. Ризик полягає в тому, що вони переміщуються. Експорт у електронні таблиці, копіювання в аналітичні інструменти, подальші набори даних, що надходять у сховища даних: щоразу, коли структуровані дані залишають своє контрольоване середовище, вони можуть втратити й свої засоби захисту. Захист на рівні полів у вихідній базі даних не поширюється на CSV-файл, експортований на загальний диск.
Що таке неструктуровані дані?
Неструктуровані дані не мають заздалегідь визначеного формату. Вони не відповідають фіксованим полям, не впорядковуються у таблиці та можуть містити практично будь-що. Типові приклади:
- Контракти, угоди про нерозголошення та юридичні документи.
- Електронні листи, повідомлення в чаті та вміст інструментів для спільної роботи.
- Клінічні записи та історії хвороби пацієнтів.
- Презентації, PDF-файли та дослідницькі звіти.
- Зображення, аудіозаписи та відеофайли
- Контент, створений штучним інтелектом, та навчальні набори даних для штучного інтелекту.
Неструктуровані дані становлять переважну більшість корпоративних даних, і ця частка продовжує зростати. Вони накопичуються у хмарних сховищах, на платформах для спільної роботи, у файлових системах кінцевих пристроїв та локальних файлових ресурсах, часто таким чином, що їх легко пропустити: старі версії, тіньові сховища, особисті хмарні облікові записи та інструменти штучного інтелекту, що обробляють файли від імені користувачів.
Проблема безпеки полягає не лише в обсязі даних. Конфіденційна інформація може з’явитися де завгодно в неструктурованих даних, без попередження. PDF-файл контракту може містити персональні дані, фінансові умови та дані, що підлягають регулюванню, в одному документі без будь-яких позначених полів для маркування. Традиційні політики запобігання втраті даних, розроблені для структурованих середовищ, тут працюють гірше, оскільки немає схеми, на яку можна спиратися під час створення правила.
Що таке напівструктуровані дані?
Між структурованими та неструктурованими даними знаходяться напівструктуровані дані: формати, що містять ідентифікаційні маркери без суворого дотримання схеми. До цієї категорії належать JSON, XML, HTML та журнали подій. Вони широко поширені у відповідях API, файлах конфігурації, системах IoT та конвеєрах штучного інтелекту/машинного навчання.
Для роботи з напівструктурованими даними зазвичай потрібні інструменти, здатні аналізувати як метадані, так і вміст — перевірка схеми, XPath-запити або вилучення даних на основі ШІ. З точки зору безпеки такі дані часто несуть у собі ризики, характерні для неструктурованих даних: мінливий вміст, непослідовне маркування конфіденційності та швидке зростання обсягів у різних системах.
Чим відрізняються структуровані та неструктуровані дані?
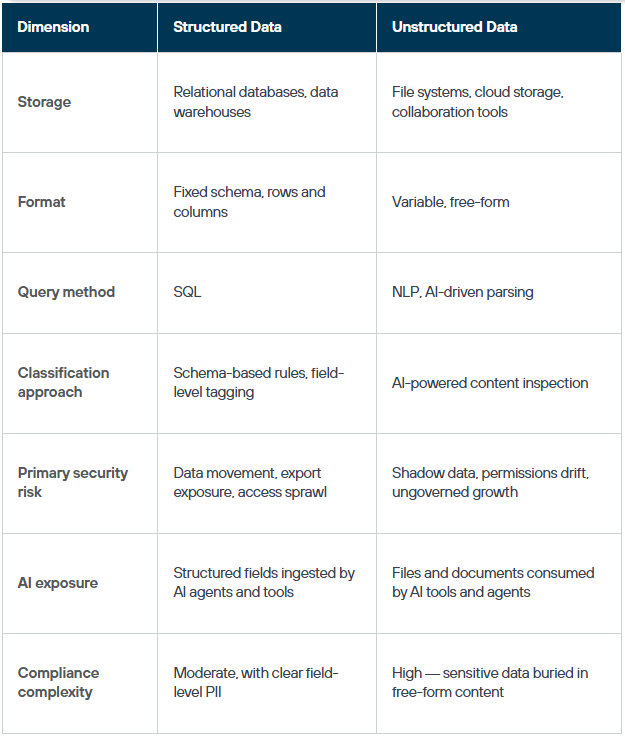
Чому ризики безпеки різняться
Більшість дискусій щодо структурованих та неструктурованих даних зосереджується на зберіганні та аналізі. Наслідки для безпеки є більш серйозними, але про них говорять рідше.
Структуровані дані: контрольовані, але не ізольовані.
Структуровані дані, як правило, простіше класифікувати, оскільки схема вказує, що містить кожне поле. Стовпець із позначкою «SSN» легко позначити та захистити. Реальний ризик витоку виникає, коли ці дані залишають регульоване середовище.
Експорт баз даних у електронні таблиці, запити аналітиків, що інтегруються в інструменти бізнес-аналітики, копії озер даних, що створюються для навчання ШІ: кожна передача створює новий екземпляр даних, який може не успадковувати вихідні права доступу. Служби безпеки часто виявляють, що їхні найбільш конфіденційні структуровані дані існують у десятках копій, розкиданих по різних середовищах із неузгодженими правами доступу. Тіньові структуровані дані становлять значний і недооцінений ризик.
Неструктуровані дані: вони всюди, і їх важко знайти.
Неструктуровані дані становлять окрему проблему. Конфіденційний вміст не позначений. У юридичному договорі на 14-й сторінці не вказано, що він містить персональні дані. У листуванні електронною поштою не зазначено, що воно містить власну цінову стратегію. Традиційні політики захисту від витоку даних, побудовані на основі відомих шаблонів, виявляють частину таких вразливостей, але безпека неструктурованих даних вимагає сканування з урахуванням змісту, яке зчитує та інтерпретує саме зміст, а не лише його структурні атрибути.
Ще однією серйозною проблемою є розширення прав доступу. У міру накопичення файлів у хмарних сховищах, інструментах для спільної роботи та на кінцевих пристроях права доступу змінюються. Користувачі, яким більше не потрібен доступ до папки, зберігають його. Спільні диски стають квазі-загальнодоступними. Надлишкові, застарілі та тривіальні дані накопичуються з часом, і групи безпеки втрачають уявлення про те, яку конфіденційну інформацію містять ці старі файли.
Штучний інтелект збільшує обидва ризики.
Інструменти штучного інтелекту обробляють як структуровані, так і неструктуровані дані у великих обсягах, часто без відома команди з безпеки. Співробітник, який вводить витяг із бази даних у ChatGPT, виводить структуровані дані за межі регульованих каналів. Співробітник, який запитує у Copilot короткий виклад конфіденційного контракту, переміщує неструктуровані дані через інструмент, який обробляє їх на зовнішній інфраструктурі. Агентна система ШІ, яка сканує SharePoint для виконання завдання, завантажує неструктуровані дані з тими правами доступу, які успадкував агент.
Кожен запит — це передача даних. Кожна взаємодія зі ШІ — це потенційна подія витоку інформації, і більшості підприємств бракує засобів контролю, щоб відстежувати це в режимі реального часу.
Як класифікувати структуровані та неструктуровані дані
Точна класифікація — основа будь-якої програми забезпечення безпеки даних. Без неї неможливо застосовувати правильні політики, забезпечувати контроль доступу або відповідати вимогам законодавства. Підхід різниться залежно від типу даних.
Класифікація структурованих даних
Класифікація структурованих даних починається зі схеми. Оскільки поля мають певні типи, правила класифікації можуть застосовуватися на рівні стовпців або таблиць: позначати стовпці мітками «номер соціального страхування», «номер рахунку» або «дата народження»; перевіряти типи даних на відповідність очікуваним форматам; позначати цілі таблиці залежно від рівня конфіденційності їхнього найбільш конфіденційного поля.
Головна проблема — охоплення. У більшості організацій баз даних, сховищ даних та копій більше, ніж їхні команди з безпеки встигли каталогізувати. Програма класифікації структурованих даних має починатися з виявлення: знайти кожну базу даних, скласти карту її вмісту та визначити, де були створені копії.
Класифікація неструктурованих даних
Класифікація неструктурованих даних не може ґрунтуватися на схемах. Вона вимагає аналізу змісту. Моделі класифікації на основі штучного інтелекту сканують документи, електронні листи та файли, виявляють конфіденційні закономірності — персональні дані, фінансові терміни, дані, що підлягають регулюванню — та присвоюють мітки конфіденційності на основі того, що міститься у вмісті, а не того, що передбачає назва файлу.
Робочий процес відбувається за єдиним шаблоном незалежно від використовуваних інструментів:
- Дізнайтеся, де у вашому середовищі зберігаються неструктуровані дані.
- Сканування та аналіз контенту за допомогою класифікаторів на основі штучного інтелекту.
- Застосуйте мітки конфіденційності («Конфіденційно», «Персональні дані», «Регульований контент» тощо).
- Складіть карту прав доступу та визначте, хто і до чого може отримати доступ.
- Встановіть правила застосування, прив’язані до класифікаційних міток.
- Постійно відстежуйте зміни обсягу, доступності або чутливості.
Слово «безперервно» у шостому кроці має ключове значення. Середовища неструктурованих даних не залишаються статичними. Файли переміщуються, права доступу змінюються, з’являються нові сховища, а в старих накопичується конфіденційна інформація, якої не було під час останнього сканування.
Як інструменти штучного інтелекту змінюють оцінку ризиків
Наразі більшість підприємств використовують інструменти штучного інтелекту в масштабах усієї організації. Деякі з них санкціоновані та централізовано управляються. Багато — ні. Співробітники використовують особисті облікові записи на ChatGPT, Claude, Gemini та інших платформах, завантажуючи файли та вставляючи контент, який ніколи не був дозволений для цих ресурсів.
Це створює ризик, що стосується обох типів даних:
- Схвалені інструменти ШІ — затверджені помічники, такі як Microsoft Copilot, працюють з вашими даними, але можуть отримувати надмірно широкі права доступу, отримуючи доступ до файлів і баз даних, до яких співробітники технічно мають доступ, але якими їм не слід ділитися з моделлю ШІ.
- «Тіньовий» ШІ — використання співробітниками несанкціонованих інструментів є неконтрольованим каналом витоку даних. Неструктуровані дані передаються через ці інструменти без будь-якої прозорості щодо того, що саме було передано.
- Агентний ШІ — автономні агенти отримують доступ до структурованих даних у базах даних, сканують неструктуровані дані у файлових системах і приймають рішення на основі знайденої інформації. Без належного управління агенти можуть ненавмисно розкрити конфіденційні дані в декількох системах у рамках одного автоматизованого робочого процесу.
Різниця між типами даних має значення, оскільки кожен тип даних по-різному реагує на дії ШІ. Розкриття структурованих даних за допомогою ШІ часто пов’язане з проблемами передачі даних — експортом записів, копіюванням запитів, вставкою результатів роботи бази даних. Розкриття неструктурованих даних складніше виявити, оскільки їхній вміст мінливий, а взаємодія зі ШІ не завжди забезпечує чіткий аудиторський слід.
Як Forcepoint обробляє обидва типи даних
Для захисту структурованих і неструктурованих даних потрібна платформа, яка забезпечує виявлення, класифікацію та контроль як структурованих, так і неструктурованих даних, не розглядаючи їх як окремі завдання.
Forcepoint AI Data Security керує даними на кожному етапі взаємодії з ШІ: дозволені додатки, тіньові інструменти ШІ та агентські системи ШІ. Вона працює на основі трирівневої моделі — «Знати, Адаптуватися, Захищати» — яка починається з класифікації конфіденційних даних та виявлення кожного активного інструменту ШІ у вашому середовищі, автоматично коригує політики у міру зміни активності ШІ та контексту ризику, а потім у режимі реального часу застосовує вбудовані засоби контролю для запобігання втраті даних між людьми, інструментами та автономними агентами. Класифікація даних для безпечного використання ШІ — основа цього підходу: без знання того, які дані є конфіденційними, жоден рівень контролю не зможе надійно їх захистити.
Forcepoint DSPM забезпечує безперервне виявлення та класифікацію на основі штучного інтелекту в структурованих базах даних і озерах даних, а також у сховищах неструктурованих файлів, хмарних сховищах та інструментах для спільної роботи. Виявляє тіньові дані, неправильні конфігурації та відхилення в правах доступу, визначає пріоритетність ризиків за ступенем серйозності та відстежує переміщення даних у гібридних середовищах.
Forcepoint DLP впроваджує політики в точці дії, чи то експорт структурованої бази даних на особисту електронну пошту, чи то завантаження неструктурованого документа в несанкціонований інструмент штучного інтелекту. Політики, що застосовуються до секретних даних, передаються разом із ними різними каналами та до кінцевих точок.
Класифікація без контролю — це лише звіт. Контроль без точної класифікації призводить до втоми від сповіщень та проблем. Коли виявлення, класифікація та контроль здійснюються в рамках єдиної політики для обох типів даних, групи безпеки отримують контроль, який вони можуть підтримувати.
Що чекає на безпеку структурованих і неструктурованих даних у майбутньому?
Низка тенденцій підкреслює необхідність правильного вирішення цієї проблеми.
Впровадження ШІ продовжує збільшувати обсяг як структурованих, так і неструктурованих даних, що передаються через неконтрольовані канали. Структуровані записи, неструктуровані документи та напівструктуровані дані API регулярно проходять через інструменти ШІ, часто без будь-яких спеціальних механізмів контролю. У міру розвитку безпеки корпоративного ШІ попит на уніфіковане управління даними, що охоплює всі типи даних, буде лише зростати.
Розширення хмарних платформ продовжує збільшувати площу поверхні, що піддається ризику, пов’язаному з неструктурованими даними. У міру того, як співпраця переходить на платформи SaaS, а зберігання файлів — до хмарних провайдерів, кількість місць, де накопичуються конфіденційні неструктуровані дані, багаторазово зростає.
Все більш суворі нормативні вимоги зобов’язують організації доводити, що вони знають, де зберігаються конфіденційні дані, хто має до них доступ і як вони захищені — як у структурованих, так і в неструктурованих середовищах. GDPR, HIPAA, CCPA та нові правила, що стосуються штучного інтелекту, не роблять різниці між полем бази даних і PDF-файлом договору. Ваша політика дотримання вимог повинна охоплювати обидва типи даних.
Випередити конкурентів зможуть ті організації, які перестануть розглядати структуровані та неструктуровані дані як окремі проблеми й почнуть застосовувати єдиний підхід до забезпечення безпеки як структурованих, так і неструктурованих даних.
Поширені запитання: Безпека структурованих та неструктурованих даних
Чим відрізняються політики захисту від витоку даних (DLP) при застосуванні до структурованих та неструктурованих даних?
Для структурованих даних політики DLP зазвичай працюють на рівні полів або таблиць, блокуючи передачу даних із відомими типами конфіденційних полів, такими як номери соціального страхування, номери рахунків або класифіковані поля. Для неструктурованих даних ефективна DLP вимагає перевірки вмісту: політика аналізує документ або повідомлення, щоб визначити, чи містить воно конфіденційну інформацію, оскільки немає схеми, на яку можна було б покладатися. Саме тому класифікація на основі штучного інтелекту має центральне значення для DLP неструктурованих даних.
Чи охоплює DSPM як структуровані, так і неструктуровані дані?
Сучасні рішення DSPM охоплюють обидва типи даних. Forcepoint DSPM виявляє та класифікує конфіденційні дані в реляційних базах даних та озерах даних (структуровані), а також у файлових сховищах, хмарних сховищах та інструментах для спільної роботи (неструктуровані). Раніше продукти DSPM часто зосереджувалися переважно на неструктурованих даних. Розширення охоплення на середовища структурованих даних усуває суттєвий пробіл, особливо для організацій, що працюють із конфіденційними робочими навантаженнями в корпоративних базах даних.
Як впровадження ШІ впливає на рівень безпеки обох типів даних?
Інструменти штучного інтелекту обробляють як структуровані, так і неструктуровані дані. Коли співробітники використовують дозволені інструменти ШІ, такі як Copilot, або несанкціоновані споживчі інструменти, вони передають дані поза межами звичайних засобів контролю безпеки. Агентні системи ШІ погіршують цю ситуацію, отримуючи доступ до даних автономно в рамках автоматизованих робочих процесів. Ефективний захист даних за допомогою ШІ вимагає прозорості щодо того, які інструменти ШІ активні, до яких даних вони звертаються та чи були ці дані належним чином класифіковані до початку взаємодії.
У чому полягає різниця між виявленням даних та їхньою класифікацією?
Виявлення визначає, де знаходяться дані: у яких базах даних, файлових сховищах, хмарних сховищах та кінцевих пристроях вони містяться. Класифікація визначає, що містять ці дані та наскільки вони є конфіденційними. Обидва процеси необхідні для забезпечення ефективної безпеки. Виявлення без класифікації показує, де знаходяться дані, але не вказує, яких заходів захисту вони потребують. Класифікація без виявлення означає, що ви класифікуєте дані, про які вже знали, тоді як некласифіковані дані накопичуються в інших місцях.
Як поширення дозволів та тіньові дані пов’язані з ризиком, пов’язаним із неструктурованими даними?
Розповзання прав доступу описує накопичення надлишкових прав доступу з плином часу: користувачі, які залишають проєкт, але зберігають доступ до папок; спільні диски, що перетворюються на квазі-публічні репозиторії; успадковані права доступу, які повинні бути більш суворими. «Тіньові» дані — це конфіденційні дані, що існують у репозиторіях, про які команди з безпеки не знають. Обидві проблеми особливо гостро стоять у випадку неструктурованих даних, оскільки неструктуровані середовища розвиваються органічно й часто без централізованого управління. DSPM вирішує обидві проблеми, безперервно зіставляючи права доступу з процесом виявлення даних.
Джерело: Structured vs. Unstructured Data: Why Controls Differ

