

Организации хранят два принципиально разных типа данных, и большинство программ обеспечения безопасности обрабатывают их одинаково. В этом и проблема.
Структурированные данные хранятся в базах данных, следуют фиксированным схемам и ведут себя предсказуемо. Неструктурированные данные находятся повсюду: в контрактах, электронных письмах, журналах чатов, PDF-файлах, аудиофайлах, презентациях. Они не подчиняются никаким правилам, не соблюдают никаких схем и растут быстрее, чем большинство команд могут отследить. Каждый тип данных требует различного управления, различных мер контроля и, в случае возникновения проблем, различного реагирования на инциденты.
В этой статье объясняются различия между структурированными и неструктурированными данными, почему эти различия создают разные риски безопасности и как применять надлежащие меры защиты в облачных, локальных и ИИ-средах.
Что такое структурированные данные?
Структурированные данные — это информация, организованная в рамках заранее определенной схемы. Они располагаются в строках и столбцах с фиксированными типами полей, определенными связями и предсказуемыми шаблонами. Типичные примеры включают:
- В CRM-системе имеются записи о клиентах с полями для имени, электронной почты и статуса учетной записи.
- Журналы транзакций в финансовой базе данных
- Медицинские записи со стандартизированными идентификаторами
- Таблицы учета запасов и цепочки поставок в системе ERP.
- Данные о персонале хранятся в согласованных, проверенных полях.
Поскольку структурированные данные следуют схеме, к ним можно выполнять запросы с помощью SQL, их можно проверять стандартными инструментами и относительно легко классифицировать. Вы знаете, где находятся данные, что они содержат и кто имеет к ним доступ. Эта предсказуемость — их сильная сторона, но она также создает ложное чувство контроля.
Риск, связанный со структурированными данными, заключается не в том, что их сложно найти. Риск в том, что они перемещаются. Экспорт в электронные таблицы, копирование в аналитические инструменты, последующие наборы данных, поступающие в хранилища данных: каждый раз, когда структурированные данные покидают свой контролируемый дом, они могут потерять и свои средства защиты. Защита на уровне полей в исходной базе данных не распространяется на CSV-файл, экспортированный на общий диск.
Что такое неструктурированные данные?
Неструктурированные данные не имеют предопределенного формата. Они не соответствуют фиксированным полям, не организуются в таблицы и могут содержать практически что угодно. Типичные примеры:
- Контракты, соглашения о неразглашении и юридические документы.
- Электронные письма, сообщения в чате и контент инструментов для совместной работы.
- Клинические записи и истории болезни пациентов
- Презентации, PDF-файлы и исследовательские отчеты.
- Изображения, аудиозаписи и видеофайлы
- Контент, созданный ИИ, и обучающие наборы данных для ИИ.
Неструктурированные данные составляют подавляющее большинство корпоративных данных, и эта доля продолжает расти. Они накапливаются в облачных хранилищах, платформах для совместной работы, файловых системах конечных устройств и локальных файловых ресурсах, зачастую таким образом, что это легко упустить из виду: старые версии, теневые хранилища, личные облачные учетные записи и инструменты искусственного интеллекта, обрабатывающие файлы от имени пользователей.
Проблема безопасности заключается не только в объеме данных. Конфиденциальная информация может появиться где угодно в неструктурированных данных, без предупреждения. PDF-файл контракта может содержать персональные данные, финансовые условия и регулируемые данные в одном документе без каких-либо помеченных полей для маркировки. Традиционные политики предотвращения потери данных, разработанные для структурированных сред, здесь работают хуже, поскольку нет схемы, на которую можно опереться при создании правила.
Что такое полуструктурированные данные?
Между структурированными и неструктурированными данными находятся полуструктурированные данные: форматы, содержащие идентификационные маркеры без жесткого соблюдения схемы. К этой категории относятся JSON, XML, HTML и журналы событий. Они широко распространены в ответах API, файлах конфигурации, системах IoT и конвейерах искусственного интеллекта/машинного обучения.
Для работы с полуструктурированными данными обычно требуются инструменты, способные анализировать как метаданные, так и содержимое — проверка схемы, XPath-запросы или извлечение данных на основе ИИ. С точки зрения безопасности, такие данные часто несут в себе риски, характерные для неструктурированных данных: переменное содержимое, непоследовательная маркировка конфиденциальности и быстрый рост в разных системах.
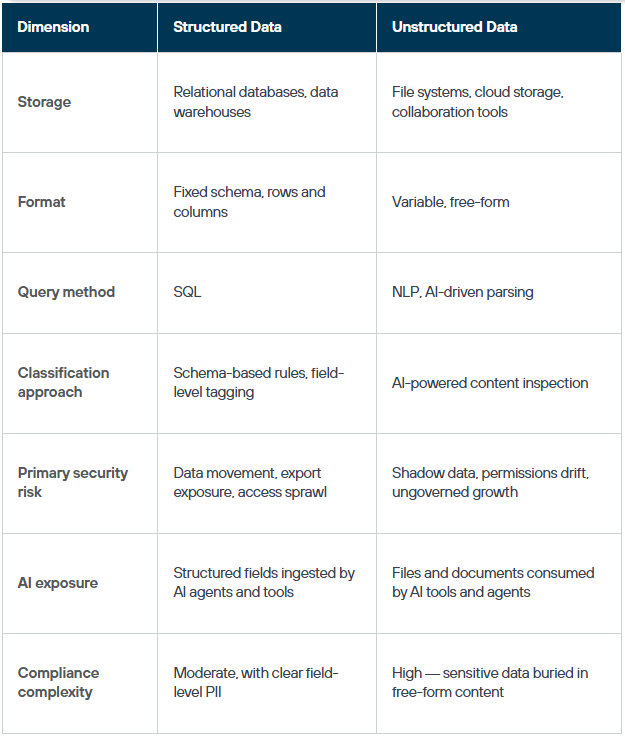
Чем отличаются структурированные и неструктурированные данные?
Почему риски безопасности различаются
Большинство дискуссий о структурированных и неструктурированных данных сосредоточены на хранении и анализе. Последствия для безопасности более серьезны и обсуждаются реже.
Структурированные данные: контролируемые, но не изолированные.
Структурированные данные, как правило, проще классифицировать, поскольку схема указывает, что содержит каждое поле. Столбец с пометкой «SSN» легко пометить и защитить. Реальный риск утечки возникает, когда эти данные покидают регулируемую среду.
Экспорт баз данных в электронные таблицы, запросы аналитиков, интегрируемые в инструменты бизнес-аналитики, копии озер данных, создаваемые для обучения ИИ: каждая передача создает новый экземпляр данных, который может не наследовать исходные права доступа. Команды безопасности часто обнаруживают, что их наиболее конфиденциальные структурированные данные существуют в десятках копий, разбросанных по различным средам с несогласованными правами доступа. Теневые структурированные данные представляют собой значительный и недооцененный риск.
Неструктурированные данные: повсюду, и их трудно найти.
Неструктурированные данные представляют собой другую проблему. Конфиденциальный контент не помечен. В юридическом договоре на 14-й странице не указывается, что он содержит персональные данные. В переписке по электронной почте не отмечается, что она включает в себя собственную ценовую стратегию. Традиционные политики защиты от утечки данных, построенные на основе известных шаблонов, выявляют часть таких уязвимостей, но безопасность неструктурированных данных требует сканирование с учетом содержимого, которое считывает и интерпретирует само содержимое, а не только его структурные атрибуты.
Другой серьезной проблемой является разрастание прав доступа. По мере накопления файлов в облачных хранилищах, инструментах для совместной работы и на конечных устройствах права доступа меняются. Пользователи, которым больше не нужен доступ к папке, сохраняют его. Общие диски становятся квази-общедоступными. Избыточные, устаревшие и тривиальные данные накапливаются со временем, и группы безопасности теряют представление о том, какую конфиденциальную информацию содержат эти старые файлы.
Искусственный интеллект увеличивает оба риска.
Инструменты искусственного интеллекта обрабатывают как структурированные, так и неструктурированные данные в больших масштабах, часто без ведома команды безопасности. Сотрудник, вставляющий вывод базы данных в ChatGPT, перемещает структурированные данные за пределы регулируемых каналов. Сотрудник, запрашивающий у Copilot краткое изложение конфиденциального контракта, перемещает неструктурированные данные через инструмент, который обрабатывает их на внешней инфраструктуре. Агентная система ИИ, сканирующая SharePoint для выполнения задачи, загружает неструктурированные данные с теми правами доступа, которые унаследовал агент.
Каждый запрос — это передача данных. Каждое взаимодействие с ИИ — это потенциальное событие утечки информации, и большинству предприятий не хватает средств контроля, чтобы отслеживать это в режиме реального времени.
Как классифицировать структурированные и неструктурированные данные
Точная классификация — основа любой программы обеспечения безопасности данных. Без неё невозможно применять правильные политики, обеспечивать контроль доступа или соответствовать требованиям законодательства. Подход различается в зависимости от типа данных.
Классификация структурированных данных
Классификация структурированных данных начинается со схемы. Поскольку поля имеют определенные типы, правила классификации могут применяться на уровне столбцов или таблиц: помечать столбцы с метками «номер социального страхования», «номер счета» или «дата рождения»; проверять типы данных на соответствие ожидаемым форматам; помечать целые таблицы в зависимости от конфиденциальности их наиболее конфиденциального поля.
Главная проблема — охват. У большинства организаций больше баз данных, хранилищ данных и копий, чем их команды безопасности каталогизировали. Программа классификации структурированных данных должна начинаться с обнаружения: найти каждую базу данных, составить карту ее содержимого и определить, где были созданы копии.
Классификация неструктурированных данных
Классификация неструктурированных данных не может полагаться на схемы. Она требует чтения содержимого. Модели классификации на основе ИИ сканируют документы, электронные письма и файлы, выявляют конфиденциальные закономерности — персональные данные, финансовые термины, регулируемые данные — и присваивают метки конфиденциальности на основе того, что говорится в содержимом, а не того, что предполагает имя файла.
Рабочий процесс следует единому шаблону независимо от используемых инструментов:
- Узнайте, где в вашей среде хранятся неструктурированные данные.
- Сканирование и анализ контента с помощью классификаторов на основе искусственного интеллекта.
- Примените метки конфиденциальности (Конфиденциально, Персональные данные, Регулируемый контент и т. д.).
- Составьте карту прав доступа и определите, кто и к чему может получить доступ.
- Установите правила применения, привязанные к классификационным меткам.
- Постоянно отслеживайте изменения объема, доступности или чувствительности.
Слово «непрерывно» в шестом шаге имеет ключевое значение. Среды неструктурированных данных не остаются статичными. Файлы перемещаются, права доступа меняются, появляются новые хранилища, а в старых накапливается конфиденциальная информация, которой не было при последнем сканировании.
Как инструменты искусственного интеллекта меняют расчет рисков
В настоящее время большинство предприятий используют инструменты искусственного интеллекта в масштабах всей организации. Некоторые из них санкционированы и централизованно управляются. Многие — нет. Сотрудники используют личные учетные записи на ChatGPT, Claude, Gemini и других платформах, загружая файлы и вставляя контент, который никогда не был разрешен для этих ресурсов.
Это создает риск, затрагивающий оба типа данных:
- Одобренные инструменты ИИ — утвержденные помощники, такие как Microsoft Copilot, работают с вашими данными, но могут наследовать чрезмерно широкие права доступа, получая доступ к файлам и базам данных, к которым сотрудники технически имеют доступ, но которыми им не следует делиться с моделью ИИ.
- Теневой ИИ — использование сотрудниками несанкционированных инструментов представляет собой неконтролируемый канал утечки данных. Неструктурированные данные передаются через эти инструменты без какой-либо прозрачности в отношении того, что именно было передано.
- Агентный ИИ — автономные агенты получают доступ к структурированным данным в базах данных, сканируют неструктурированные данные в файловых системах и принимают решения на основе найденной информации. Без надлежащего управления агенты могут непреднамеренно раскрыть конфиденциальные данные в нескольких системах в рамках одного автоматизированного рабочего процесса.
Различие типов данных имеет значение, поскольку каждый тип данных по-разному реагирует на действия ИИ. Раскрытие структурированных данных через ИИ часто связано с проблемами передачи данных — экспортом записей, копированием запросов, вставкой результатов работы базы данных. Раскрытие неструктурированных данных сложнее обнаружить, поскольку их содержимое изменчиво, а взаимодействие с ИИ не всегда обеспечивает чистый след аудита.
Как Forcepoint обрабатывает оба типа данных
Для защиты структурированных и неструктурированных данных необходима платформа, которая обеспечивает обнаружение, классификацию и контроль как структурированных, так и неструктурированных данных, не рассматривая их как отдельные задачи.
Forcepoint AI Data Security управляет данными на каждом этапе взаимодействия с ИИ: разрешенные приложения, теневые инструменты ИИ и агентные системы ИИ. Она работает на основе трехуровневой модели — «Знать, Адаптироваться, Защищать» — которая начинается с классификации конфиденциальных данных и обнаружения каждого активного инструмента ИИ в вашей среде, автоматически корректирует политики по мере изменения активности ИИ и контекста риска, а затем в режиме реального времени применяет встроенные средства контроля для предотвращения потери данных между людьми, инструментами и автономными агентами. Классификация данных для безопасного использования ИИ — основа этого подхода: без знания того, какие данные являются конфиденциальными, ни один уровень контроля не сможет надежно их защитить.
Forcepoint DSPM обеспечивает непрерывное обнаружение и классификацию на основе ИИ в структурированных базах данных и озерах данных, а также в хранилищах неструктурированных файлов, облачных хранилищах и инструментах для совместной работы. Выявляет теневые данные, неправильные конфигурации и отклонения в правах доступа, определяет приоритетность рисков по степени серьезности и отслеживает перемещение данных в гибридных средах.
Forcepoint DLP внедряет политики в точке действия, будь то экспорт структурированной базы данных на личную электронную почту или загрузка неструктурированного документа в несанкционированный инструмент ИИ. Политики, применяемые к секретным данным, передаются вместе с ними по различным каналам и конечным точкам.
Классификация без контроля — это всего лишь отчет. Контроль без точной классификации приводит к усталости от оповещений и проблемам. Когда обнаружение, классификация и контроль осуществляются в рамках единой политики для обоих типов данных, группы безопасности получают контроль, который они могут поддерживать.
Что ждет безопасность структурированных и неструктурированных данных в будущем?
Ряд тенденций усиливает необходимость правильного решения этой проблемы.
Внедрение ИИ продолжает увеличивать объём как структурированных, так и неструктурированных данных, передаваемых по неконтролируемым каналам. Структурированные записи, неструктурированные документы и полуструктурированные данные API регулярно проходят через инструменты ИИ, часто без каких-либо специальных механизмов контроля. По мере развития безопасности корпоративного ИИ спрос на унифицированное управление данными, охватывающее все типы данных, будет только расти.
Расширение облачных платформ продолжает увеличивать площадь поверхности, подверженной риску, связанному с неструктурированными данными. По мере того, как сотрудничество перемещается на платформы SaaS, а хранение файлов — к облачным провайдерам, количество мест, где накапливаются конфиденциальные неструктурированные данные, многократно возрастает.
Все более строгие нормативные требования обязывают организации демонстрировать, что они знают, где хранятся конфиденциальные данные, кто имеет к ним доступ и как они защищены, как в структурированных, так и в неструктурированных средах. GDPR, HIPAA, CCPA и новые правила, специфичные для ИИ, не делают различий между полем базы данных и PDF-файлом договора. Ваша политика соответствия требованиям должна охватывать оба типа данных.
Опередить конкурентов смогут те организации, которые перестанут рассматривать структурированные и неструктурированные данные как отдельные проблемы и начнут применять единый подход к обеспечению безопасности как структурированных, так и неструктурированных данных.
Часто задаваемые вопросы: Безопасность структурированных и неструктурированных данных
Чем отличаются политики защиты от утечки данных (DLP) при применении к структурированным и неструктурированным данным?
Для структурированных данных, политики DLP обычно работают на уровне полей или таблиц, блокируя передачу данных с известными типами конфиденциальных полей, такими как номера социального страхования, номера счетов или классифицированные поля. Для неструктурированных данных эффективная DLP требует проверки содержимого: политика считывает документ или сообщение, чтобы определить, содержит ли оно конфиденциальную информацию, поскольку нет схемы, на которую можно было бы полагаться. Именно поэтому классификация на основе ИИ имеет центральное значение для DLP неструктурированных данных.
Охватывает ли DSPM как структурированные, так и неструктурированные данные?
Современные решения DSPM охватывают оба типа данных. Forcepoint DSPM обнаруживает и классифицирует конфиденциальные данные в реляционных базах данных и озерах данных (структурированные), а также в файловых хранилищах, облачных хранилищах и инструментах для совместной работы (неструктурированные). Более ранние продукты DSPM часто фокусировались в основном на неструктурированных данных. Расширение охвата на среды структурированных данных устраняет существенный пробел, особенно для организаций, работающих с конфиденциальными рабочими нагрузками в корпоративных базах данных.
Как внедрение ИИ меняет уровень безопасности для обоих типов данных?
Инструменты искусственного интеллекта обрабатывают как структурированные, так и неструктурированные данные. Когда сотрудники взаимодействуют с разрешенными инструментами ИИ, такими как Copilot, или с несанкционированными потребительскими инструментами, они передают данные вне рамок обычных средств контроля безопасности. Агентные системы ИИ усугубляют эту ситуацию, получая доступ к данным автономно в рамках автоматизированных рабочих процессов. Эффективная защита данных с помощью ИИ требует прозрачности в отношении того, какие инструменты ИИ активны, к каким данным они обращаются и были ли эти данные должным образом классифицированы до начала взаимодействия.
В чём разница между обнаружением данных и классификацией данных?
Обнаружение определяет, где находятся данные: в каких базах данных, файловых хранилищах, облачных хранилищах и конечных устройствах они содержатся. Классификация определяет, что содержат эти данные и насколько они конфиденциальны. Оба процесса необходимы для эффективной безопасности. Обнаружение без классификации показывает, где находятся данные, но не указывает, какие меры защиты им необходимы. Классификация без обнаружения означает, что вы классифицируете данные, о которых уже знали, в то время как неклассифицированные данные накапливаются в других местах.
Как распространение разрешений и теневые данные связаны с риском, связанным с неструктурированными данными?
Расползание прав доступа описывает накопление избыточных прав доступа с течением времени: пользователи, покидающие проект, но сохраняющие доступ к папкам, общие диски, превращающиеся в квази-публичные репозитории, унаследованные права доступа, которые должны быть более строгими. Теневые данные описывают конфиденциальные данные, существующие в репозиториях, о которых команды безопасности не знают. Обе проблемы особенно остро стоят для неструктурированных данных, поскольку неструктурированные среды развиваются органически и часто без централизованного управления. DSPM решает обе проблемы, непрерывно сопоставляя права доступа с процессом обнаружения данных.
Источник: Structured vs. Unstructured Data: Why Controls Differ

